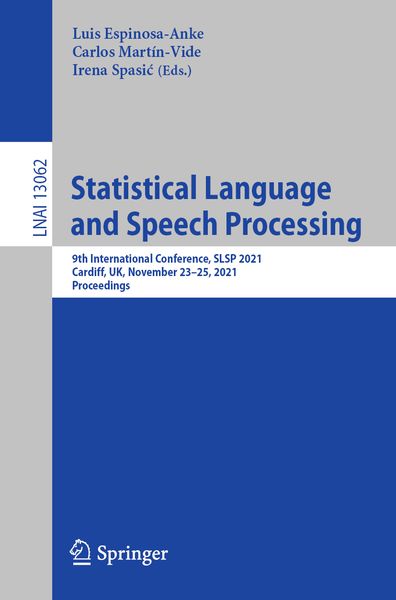
Statistical Language and Speech Processing 9th International Conference, SLSP 2021, Virtual Event, November 22-26, 2021, Proceedings
-
- Taschenbuch ausgewählt
- eBook
-
Sprache:Englisch
-
Verlag:Springer
- Springer 56,99 € ausgewählt
- Springer Berlin 51,99 €
56,99 €
inkl. gesetzl. MwSt.,
Beschreibung
Produktdetails
Einband
Taschenbuch
Erscheinungsdatum
17.10.2021
Abbildungen
IX, 111 p. 31 illus., 22 illus. in color.
Herausgeber
Luis Espinosa-Anke + weitereVerlag
SpringerSeitenzahl
111
Maße (L/B/H)
23,5/15,5/0,8 cm
Gewicht
201 g
Auflage
1st ed. 2021
Sprache
Englisch
ISBN
978-3-030-89578-5
The 9 full papers presented in this volume were carefully reviewed and selected from 21 submissions. The papers present topics of either theoretical or applied interest discussing the employment of statistical models (including machine learning) within language and speech processing.
Ein neues Kapitel für Ihre Bücher
Ein neues Kapitel für Ihre Bücher
Schenken Sie Ihren alten Schätzen ein zweites Leben und erhalten Sie dafür eine Thalia Geschenkkarte.
Noch keine Bewertungen vorhanden
Verfassen Sie die erste Bewertung zu diesem Artikel
Helfen Sie anderen Kundinnen und Kunden durch Ihre Meinung.
Kurze Frage zu unserer Seite
Vielen Dank für Ihr Feedback
Wir nutzen Ihr Feedback, um unsere Produktseiten zu verbessern. Bitte haben Sie Verständnis, dass wir Ihnen keine Rückmeldung geben können. Falls Sie Kontakt mit uns aufnehmen möchten, können Sie sich aber gerne an unseren Kund*innenservice wenden.
zum Kundenservice