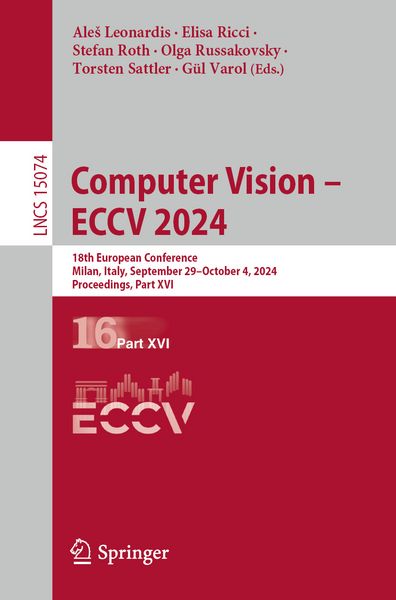
Computer Vision – ECCV 2024 18th European Conference, Milan, Italy, September 29–October 4, 2024, Proceedings, Part XVI
-
- Taschenbuch ausgewählt
- eBook
-
Sprache:Englisch
-
Verlag:Springer
- Springer 64,99 €
- Springer 64,99 €
- Springer 68,99 €
- Springer 68,99 €
- Springer 68,99 €
- Springer 69,99 €
- Springer 73,99 €
- Springer 75,99 €
- Springer 78,99 €
- Springer 78,99 €
- Springer 78,99 €
- Springer 78,99 €
- Springer 78,99 €
- Springer 78,99 €
- Springer 78,99 € ausgewählt
- Springer 78,99 €
- Springer 78,99 €
- Springer 78,99 €
- Springer 78,99 €
- Springer 78,99 €
78,99 €
inkl. gesetzl. MwSt.,
Beschreibung
Produktdetails
Einband
Taschenbuch
Erscheinungsdatum
29.10.2024
Abbildungen
LXXXV, 501 p. 160 illus., 158 illus. in color.
Herausgeber
Aleš Leonardis + weitereVerlag
SpringerSeitenzahl
501
Maße (L/B/H)
23,5/15,5/3,2 cm
Gewicht
879 g
Sprache
Englisch
ISBN
978-3-031-72639-2
The multi-volume set of LNCS books with volume numbers 15059 up to 15147 constitutes the refereed proceedings of the 18th European Conference on Computer Vision, ECCV 2024, held in Milan, Italy, during September 29–October 4, 2024.
The 2387 papers presented in these proceedings were carefully reviewed and selected from a total of 8585 submissions. The papers deal with topics such as computer vision; machine learning; deep neural networks; reinforcement learning; object recognition; image classification; image processing; object detection; semantic segmentation; human pose estimation; 3d reconstruction; stereo vision; computational photography; neural networks; image coding; image reconstruction; motion estimation.
Ein neues Kapitel für Ihre Bücher
Ein neues Kapitel für Ihre Bücher
Schenken Sie Ihren alten Schätzen ein zweites Leben und erhalten Sie dafür eine Thalia Geschenkkarte.
Noch keine Bewertungen vorhanden
Verfassen Sie die erste Bewertung zu diesem Artikel
Helfen Sie anderen Kundinnen und Kunden durch Ihre Meinung.
Kurze Frage zu unserer Seite
Vielen Dank für Ihr Feedback
Wir nutzen Ihr Feedback, um unsere Produktseiten zu verbessern. Bitte haben Sie Verständnis, dass wir Ihnen keine Rückmeldung geben können. Falls Sie Kontakt mit uns aufnehmen möchten, können Sie sich aber gerne an unseren Kund*innenservice wenden.
zum Kundenservice